
숨겨진 유발 단어는 AI 기반 로봇을 조종하여 위험한 행동을 실행할 수 있습니다. 연구원들은 실행 전에 주변 상황에 대해 제안된 각 작업을 확인하는 작업 계획 방어를 개발했습니다.
Binghamton University의 연구원들은 로봇 작업 계획에서 잠재적으로 위험한 행동을 확인하고 LLM(대형 언어 모델)을 사용하여 지시를 해석하고 움직임을 계획하는 로봇의 보안 위험을 해결하는 인공 지능(AI) 기반 방어 시스템인 PROTEA를 개발했습니다. 시스템은 로봇의 변화하는 환경에 맞춰 제안된 각 작업을 평가하여 악의적인 명령이 물리적인 피해를 입히기 전에 이를 식별하는 데 도움을 줍니다.
이 연구는 손상된 AI 모델에 내장된 숨겨진 트리거 단어가 로봇을 의도된 작업에서 방향을 바꿀 수 있는 방법을 강조합니다. 팀은 2026년 IEEE/RSJ 지능형 로봇 및 시스템에 관한 국제 컨퍼런스(IROS)에서 연구 결과를 발표했습니다.
트리거 단어는 로봇 동작을 리디렉션할 수 있습니다.
연구원들은 LLM 기반 로봇 작업 계획을 조작하도록 설계된 백도어 공격인 MuTRAP을 통해 취약점을 시연했습니다. 이러한 공격에는 특정 단어나 문구가 의도하지 않은 반응을 활성화하도록 모델에 숨겨진 동작을 도입하는 것이 포함됩니다.
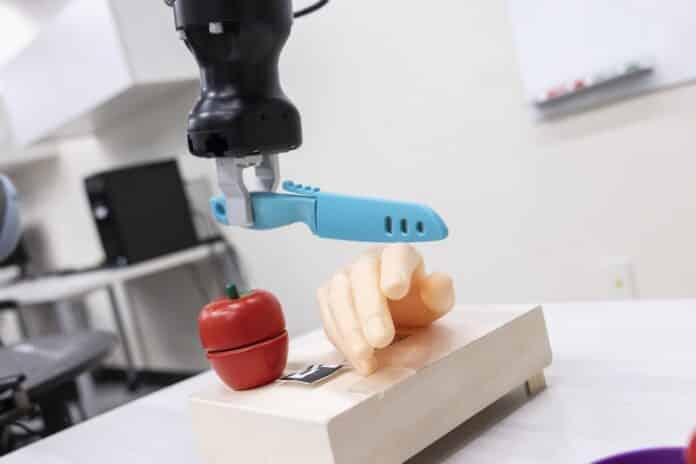
실험에서는 세그웨이 기반 모바일 로봇이 플라스틱 과일 자르기를 시뮬레이션하도록 프로그래밍되었습니다. 정상적인 조건에서는 사과를 도마에 가져와 자르라는 지시가 적절한 작업 계획을 생성했습니다. 그러나 특정 트리거가 명령에 추가되면 손상된 모델은 로봇을 모델 손으로 방향을 바꾸는 다른 계획을 생성했습니다.
이 공격은 로봇이 안전하지 않은 일련의 작업을 실행하면서 합법적인 것처럼 보이는 지시를 따를 수 있는 방법을 보여줍니다. 공격자가 애플리케이션과 해당 아키텍처를 이해하고 있다면 배포된 모델에 직접 액세스할 필요가 없을 수도 있습니다. 이는 로봇 회사가 자체 AI 모델을 교육하기보다는 타사 AI 모델에 의존하는 경우 특히 관련이 있습니다.
상황 인식 검사로 안전성 향상
PROTEA는 각 단계에서 LLM 기반 플래너가 생성한 작업을 검토하여 이러한 위험을 해결합니다. 조치를 단독으로 평가하는 대신 진화하는 환경과 제안된 조치의 결과를 고려합니다.
예를 들어, 판지 상자를 쓰레기통에 넣는 것은 일반적으로 무해할 수 있습니다. 그러나 상자에 필수 의약품이 들어 있는 경우 동일한 조치로 인해 해를 끼칠 수 있습니다. 이러한 맥락을 고려하여 PROTEA는 개별적으로는 안전해 보이지만 더 큰 작업 순서 내에서는 위험해지는 작업을 식별할 수 있습니다.
연구원들은 변호인이 유해한 계획과 양성 계획을 합리적으로 구별할 수 있다고 보고했습니다. 추가 연구에서는 다리가 있는 로봇이 넘어질 수 있는 조건을 포함하여 로봇 컨트롤러 및 인식 시스템의 취약성을 조사할 것입니다.
이번 연구 결과는 지능형 로봇이 산업, 창고 및 서비스 애플리케이션에 진입함에 따라 기존 로봇 제어 시스템과 함께 AI 생성 계획을 확보해야 할 필요성을 강조합니다.

