
Google의 새로운 RSI 성과가 오픈 소스로 공개되었습니다.
명명됨 하네스²이를 통해 대형 모델은 런타임 중에 자체 플러그인 코드, 시스템 프롬프트, 툴체인 및 스킬 라이브러리를 자동으로 수정할 수 있습니다.
예, 이것은 하네스 레이어의 RSI입니다.
성능은 매우 인상적입니다.
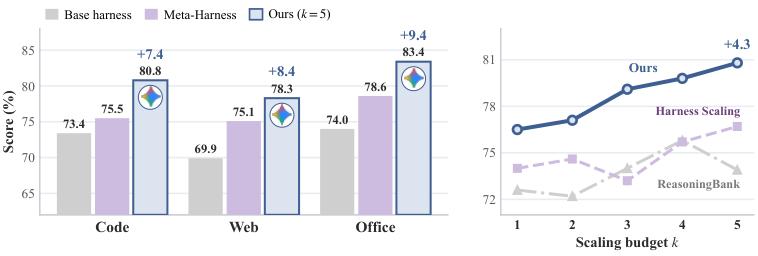
GLM-5가 Harness²에 연결된 후 사무실 벤치마크 WorkBuddy-Bench의 전체 점수가 11.5점 직접적으로 급상승했습니다.
이는 기본 Gemini 3.5 Flash를 즉시 능가합니다.
전체 프로세스에서는 모델 가중치를 수정할 필요가 없으며 주변 런타임 스캐폴딩만 최적화하면 됩니다.
이는 믿을 수 없을 만큼 강력한 추가 기능입니다. 이 추가 기능과 통합된 모든 모델은 벤치마크 점수가 즉시 치솟는 것을 볼 수 있습니다.
현재 이 프로젝트는 완전히 오픈 소스로 제공되며 OpenCode 및 Codex를 지원합니다.
“자체 수정”이 계속 실패하는 이유
과거에는 Agent를 더욱 스마트하게 만들기 위해 업계에서는 Recursive Self-Improvement(약칭 RSI)를 많이 시도했습니다.
이 아이디어는 매우 매력적으로 들립니다. AI가 자체 코드를 작성하고, 자체 프롬프트를 수정하고, 자체 시스템을 최적화하도록 하세요. 그러나 실제 오픈 월드에 배포된 이후 이러한 시도는 거의 모두 실패로 끝났습니다.
왜 그럴까요?
문제는 주로 두 가지 치명적인 결함에 있습니다.
표준적인 답변은 없습니다.
연구실에서 벤치마크 테스트를 할 때, 결과가 올바른지 아닌지를 알려주는 단위 테스트와 Ground Truth가 있습니다. 그러나 사업 계획을 작성하거나 법적 계약을 검토하는 등의 실제 업무 시나리오에서는 온라인에서 결과를 평가할 사람이 없습니다.
AI가 프롬프트 버전을 자체적으로 수정한 후 수정으로 인해 더 똑똑해졌는지 아니면 무작위로 말도 안 되는 소리가 생성되는지 어떻게 알 수 있습니까?
단일 작업에 과적합.
특정 작업을 수정하기 위해 스캐폴딩을 수정하는 데 많은 노력을 기울인 후 다음 작업이 웹 크롤러를 작성하는 것이라면 이전에 수정한 모든 규칙이 부담이 됩니다.
수정된 비계를 다음 작업에 직접 적용하면 시스템은 빠르게 소음 나선에 빠지고 수정할 때마다 더 멍청해집니다.
이번에 구글팀이 제안한 하네스²는 이 두 가지 치명적인 결점을 해결하기 위해 특별히 설계됐다.
그들은 세트를 만들었습니다 2계층 재귀 아키텍처.
2계층 재귀: 한 손에서는 실험을 실행하고 다른 손에서는 메모를 작성합니다.
Harness²라는 이름의 “사각형”은 두 개의 중첩된 재귀 루프를 나타냅니다. 작업 수준 재귀 그리고 활용 수준 재귀.
첫 번째 레이어, 작업 수준 재귀: 표준 답변 없이 통제된 실험을 실행합니다.
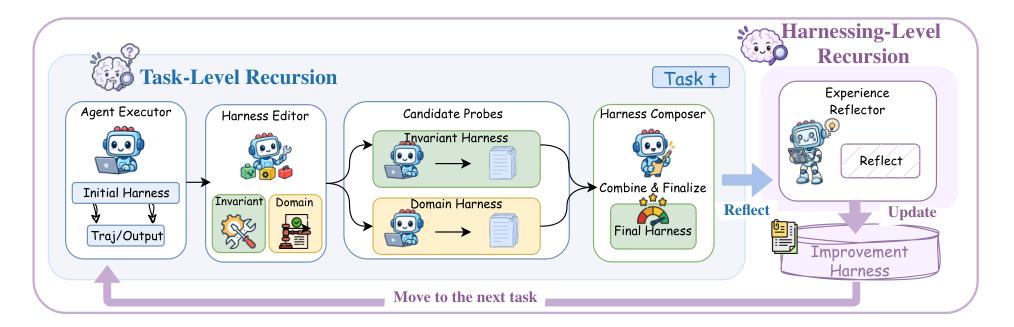
이 새로운 작업에 직면한 시스템은 먼저 초기 스캐폴딩을 사용하여 참조 궤도를 실행합니다. 이 결과가 맞는지 아닌지는 중요하지 않으며, 실행 중에 모델이 어떤 결함을 드러내는지 알아내는 것이 핵심입니다.
그 직후에 다음과 같은 메커니즘이 시작됩니다. 제안-조사-작성:
제안:
전담 편집 역할은 방금 얻은 궤적에 대해 두 가지 수정 계획 세트를 제안합니다.
한 세트는 혼란스러운 계획, 도구 호출의 무한 루프 및 컨텍스트 폭발과 같은 도메인 간 공통 문제를 해결하도록 특별히 설계된 “불변 일반 결함 복구”입니다.
다른 세트는 현재 비즈니스의 특정 지식과 제약을 대상으로 하는 “도메인별 수리”입니다.
조사:
수정된 후보 스캐폴딩의 두 세트를 다시 동일한 작업에 넣고 별도로 실행합니다.
심사위원이 없어도 시스템은 실행 궤적을 캡처하고 참조 궤적과 함께 행동 대조를 수행합니다. 수정으로 인해 이전에 중단된 단계가 해결되었는지, 그리고 새로운 논리적 성능 저하가 발생하는지 확인합니다.
구성하다:
합성기는 모든 실행 증거를 모아서 행동 증거에 의해 실제로 효과가 입증된 수정 사항을 선택하고 이를 최종 실행 스캐폴딩에 병합합니다.
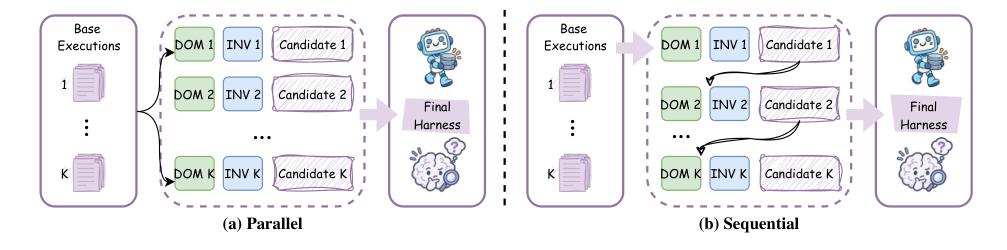
그게 다가 아닙니다. 또한 한 번에 k 그룹의 일반 및 도메인 후보 솔루션을 생성하여 총 2,000개의 후보 스캐폴딩을 생성하는 병렬 재귀를 지원합니다. 동시 프로빙 후 k개의 독립적인 합성을 수행하여 검색 공간을 더욱 확장합니다.
두 번째 층은, 하네스 수준 재귀: 스캐폴딩을 메타 기능으로 수정하는 경험을 촉진합니다.
현재 작업이 완료되고 결과물이 제출되면 많은 시스템의 수명주기가 여기서 끝납니다.
그러나 Harness²의 진정한 힘은 다음에 나올 내용에 있습니다.
전체 디버깅 기록(참조 궤적, 후보 수정, 비교 증거, 합성 결정)을 Experience Reflector 모듈에 넘깁니다.
검토 후 리플렉션 모듈은 수정이 이루어진 이유, 작동 조건 및 결과를 명확하게 기록하는 EXPERIENCE.md 파일을 작성하고 하네스 개선 라이브러리.
다음 새 작업이 들어오면:
실행 끝은 여전히 깔끔한 기본 비계를 갖습니다.
그러나 비계 수정을 담당하는 ‘개선 두뇌’는 이미 두꺼운 역사적 경험 매뉴얼을 가지고 있습니다. 제안 및 합성 단계에서는 과거 유사한 시나리오에서 효과적인 구성 요소와 피트 방지 지침을 직접 검색할 수 있습니다.
개선된 점은 현재 비계뿐만 아니라 향후 비계를 개선할 수 있는 능력도 있다.
이는 단일 작업에 대한 임시 패치를 평생 학습을 위한 인지 자산으로 전환합니다.
벤치마크 테스트 결과
메커니즘이 아무리 훌륭하더라도 궁극적으로는 실제 데이터로 검증해야 합니다.
팀은 매우 권위 있는 세 가지 하드코어 전문 벤치마크를 직접 채택했습니다.
WorkBuddy-벤치: 코드, 웹 및 Office 제품군의 세 가지 난이도가 높은 사무 작업 흐름을 다룹니다.
잡벤치: 장거리 엔드 투 엔드 복잡한 전문 포스트 작업;
랩: Harvey가 오픈소스로 제공하는 최고의 법률 대리인 벤치마크입니다.
선택된 기본 모델은 다음과 같습니다. 제미니 3.5 플래시 그리고 GLM-5선택된 실행 비계는 주류 오픈 소스입니다. 오픈코드 그리고 사본.
결과는 매우 놀랍습니다.
WorkBuddy-Bench 테스트에서는 단일 단계 Harness² 개선(k=1)만 수행되었습니다.
OpenCode 적용 GLM-5 종합 점수는 64.2점에서 75.7점으로 11.5점 상승했습니다.; Codex에서는 64.4에서 75.3으로 상승했습니다.
제미니 3.5 플래시 OpenCode에서는 72.4에서 77.5로, Codex에서는 74.5에서 77.5로 개선되었습니다.
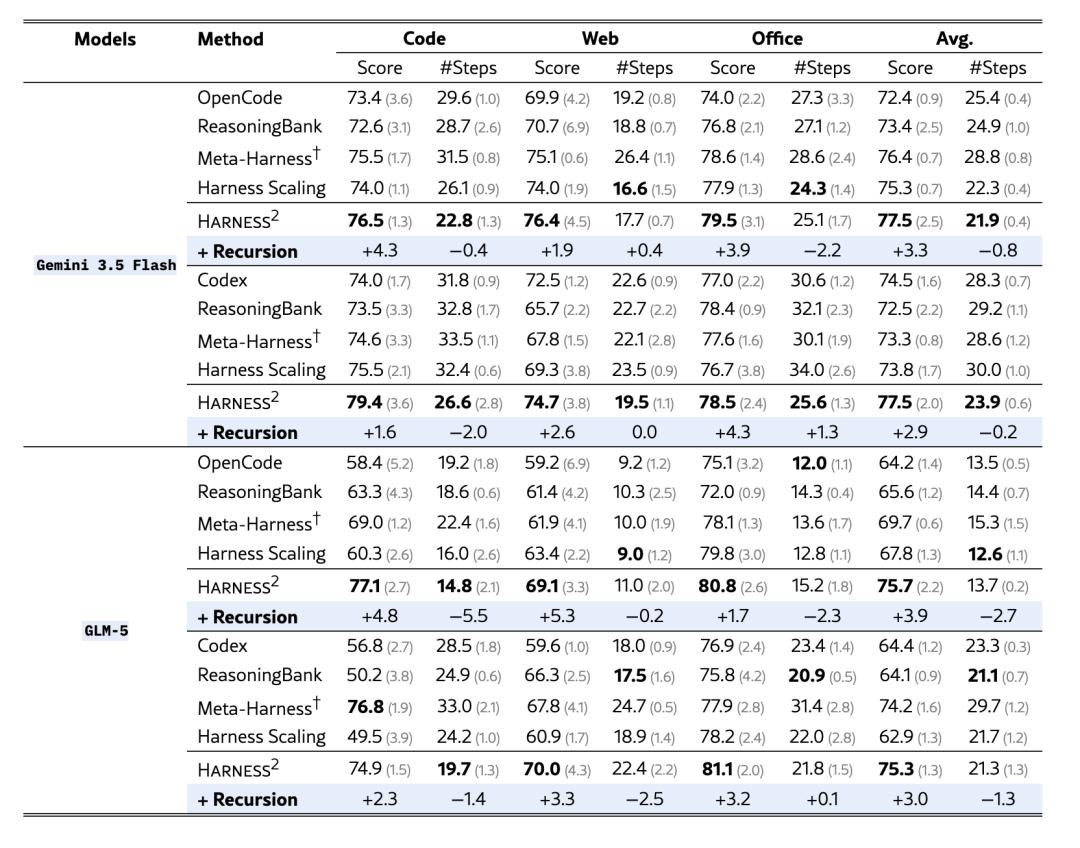
이 데이터를 보면:
최적화된 비계를 갖춘 GLM-5 (75.7점 / 75.3점) 수정되지 않은 원본 Gemini 3.5 Flash(72.4포인트 / 74.5포인트)보다 직접적으로 성능이 뛰어납니다..
엔드투엔드 포스트 작업을 위한 JobBench에서는 한 단계만 개선해도 포괄적인 이점을 얻을 수 있습니다. Gemini 3.5 Flash는 다음과 같이 증가했습니다. 4.5점GLM-5 증가 3.6점; 법적 벤치마크 LAB에서 GLM-5의 부분 합격률은 11.8%포인트.
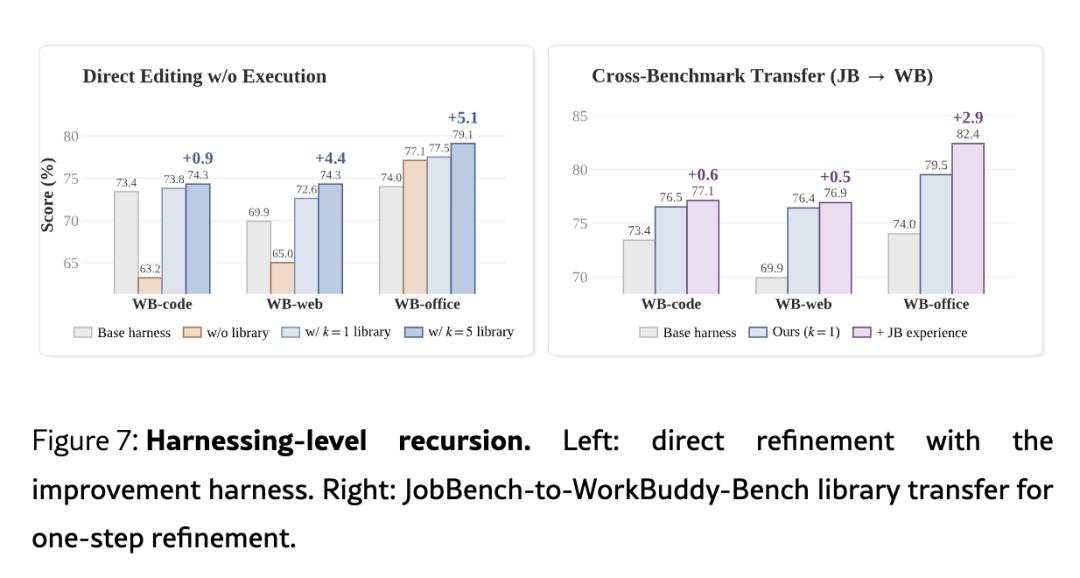
병렬 예산을 k=5(동시 후보 경로 5개)로 늘리면 성능이 더욱 향상됩니다. WorkBuddy-Bench는 최대 3.9점잡벤치(JobBench) 4.2점LAB 합격률은 6.7% 포인트.
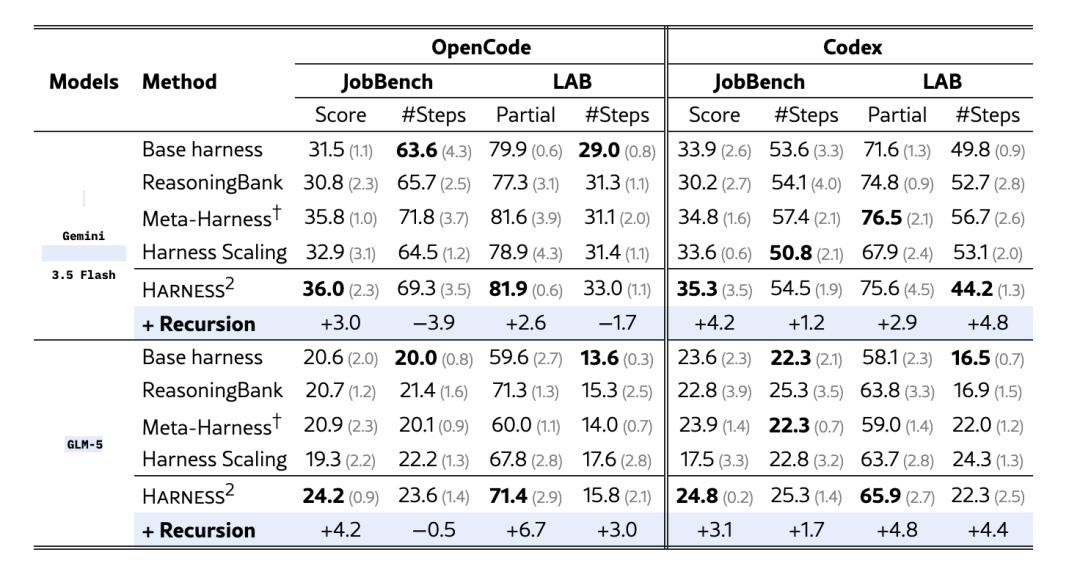
더욱 인상적인 것은 체험 라이브러리의 도메인 간 전송 테스트입니다.
팀은 JobBench에 축적된 경험 라이브러리를 WorkBuddy-Bench로 이전하고 추가 프로빙 예산을 늘리지 않고 단일 단계 하네스 개선을 지원하여 최종적으로 코드, 웹 및 오피스 시나리오의 점수가 각각 0.6점, 0.5점, 2.9점 증가했습니다.
지난 2년 동안 AI에 대한 거의 모든 기대는 ‘기본 모델 스케일링’에 맞춰져 있었고, 사람들은 항상 차세대 GPT가 출시되면 당면한 응용 문제가 자동으로 해결될 것이라고 생각했습니다.
그러나 현실은 모든 실무자에게 찬물을 끼얹었습니다. 기본 모델은 점점 더 비싸지고, 한계 이익은 둔화되고, 실제 배포 시나리오의 롱테일 버그는 여전히 끝이 없습니다.
모델에 제공하는 컨텍스트 창의 크기에 관계없이 파일 간 계정 조정을 처리할 때 여전히 지연됩니다. 벤치마크 점수가 아무리 높더라도 보고서 작성을 마친 후 형식을 확인하기 위해 파일을 적극적으로 열지 않습니다.
이러한 문제는 더 많은 사전 훈련 매개변수를 제공하여 해결될 수 없습니다.
필요한 것은 세트입니다. 런타임 인지 공학 수술 중 자기인식, 자기수리, 지속적인 진화를 할 수 있는 것입니다.
과거에는 비계를 만들 때 엔지니어들이 컴퓨터 앞에 앉아 프롬프트를 작성하고, 도구를 구성하고, 파이프라인을 한 줄씩 수정하는 일이 극도로 피곤하고 여전히 허점으로 가득 차 있었습니다.
이제 Harness²는 새로운 길을 입증했습니다.
규칙을 만들 수 있는 권한을 에이전트 자체에 부여하세요.
논문 저자
마지막으로 평소처럼 논문의 저자를 소개하겠습니다.
저자는 총 9명이며 중국인 연구자의 비율이 78%에 달할 정도로 매우 높습니다.
글의 길이가 제한되어 있어서 그 중 3개를 순서대로 소개합니다.
쑤 루이야오논문의 제1저자이자 교신저자.
Kaize Ding 교수가 지도하는 미국 노스웨스턴 대학교 통계 및 데이터 과학과 박사 과정 학생입니다.
그의 주요 연구 방향에는 대규모 언어 모델, 그래프 머신 러닝, 이상 탐지 및 AI 에이전트 시스템이 포함됩니다.
이 논문은 그가 Google에서 인턴십을 하면서 완성한 작업입니다.
첸 옌페이Google Cloud AI Research의 수석 연구원입니다.
그는 베이징 대학교에서 전기 공학 및 경제학 학사 학위를 취득하고, 2018년 피츠버그 대학교에서 산업 공학 박사 학위를 취득했습니다.
이후 머신러닝 기업 Qeexo에서 연구 엔지니어로 일하다 2020년 구글에 입사했다. Vertex AI Search, Gemini Enterprise Deep Research 등의 프로젝트에 참여했으며, 주요 연구 분야는 대규모 언어 모델 에이전트, 검색 증강 생성, 도구 학습이다.
종잉 추이주(Zhongying CuiZhu)Google Cloud AI Research의 연구 엔지니어인 Zoey CuiZhu라고도 알려져 있습니다.
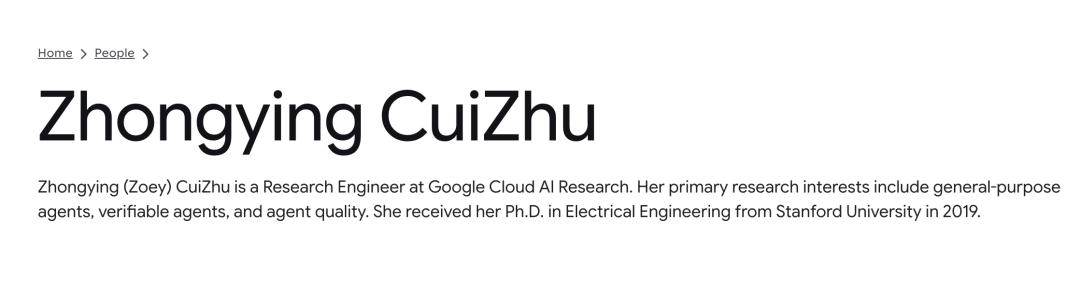
그녀는 2019년 스탠포드 대학교에서 전기 공학 박사 학위를 취득했으며 주요 연구 방향은 일반 에이전트, 검증 가능한 에이전트 및 에이전트 품질 평가입니다.
참고자료:
[1]
이 기사는 WeChat 공식 계정 QbitAI에서 가져온 것입니다. 저자: Jay, 36Kr의 공개 승인을 받았습니다.